

Calidad, ruido y latencia
Motores locales o de otros proveedores
Cada STT (el oído) y cada TTS (la voz) es local o de otro proveedor:
- Local: funciona dentro de NappAI. No necesita credencial, el audio no sale de NappAI y no tiene coste por minuto.
- De otro proveedor: un servicio externo que conectas con su credencial. Ofrece más idiomas y voces, con coste por uso según tu contrato con ese proveedor.
| Local | De otro proveedor | |
|---|---|---|
| Oír (STT) | Parakeet (local, multilingual), recomendado; Vosk (local), solo español e inglés y menos preciso, etc. | Groq Whisper, Deepgram, Azure Speech, OpenAI, Gemini, ElevenLabs, Cartesia, Gladia, Inworld, AssemblyAI, Wit.ai, etc. |
| Hablar (TTS) | Supertonic (local), recomendado; Pocket TTS (local), el que antes empieza a hablar, solo en español; Piper (local); Kokoro (local), etc. | ElevenLabs, Cartesia, Deepgram, Azure Speech, OpenAI, Gemini, Inworld, etc. |
La combinación recomendada es Parakeet + Supertonic. Si además usas un modelo local, como Ollama, el agente funciona entero dentro de tu instalación.
Parakeet entiende muy bien el español y el inglés. Con Detect Language activado, sigue al llamante si cambia de idioma. Para catalán, gallego o euskera, usa un STT de otro proveedor, como Azure Speech.
Elige un motor de otro proveedor cuando necesites un idioma que los locales no cubren, una voz de marca o la máxima naturalidad.
Con Fallback Engines activado en el componente Voice Agent puedes conectar un segundo modelo, STT y TTS. Toman el relevo si el principal falla en plena llamada.
Entornos ruidosos y voces de fondo
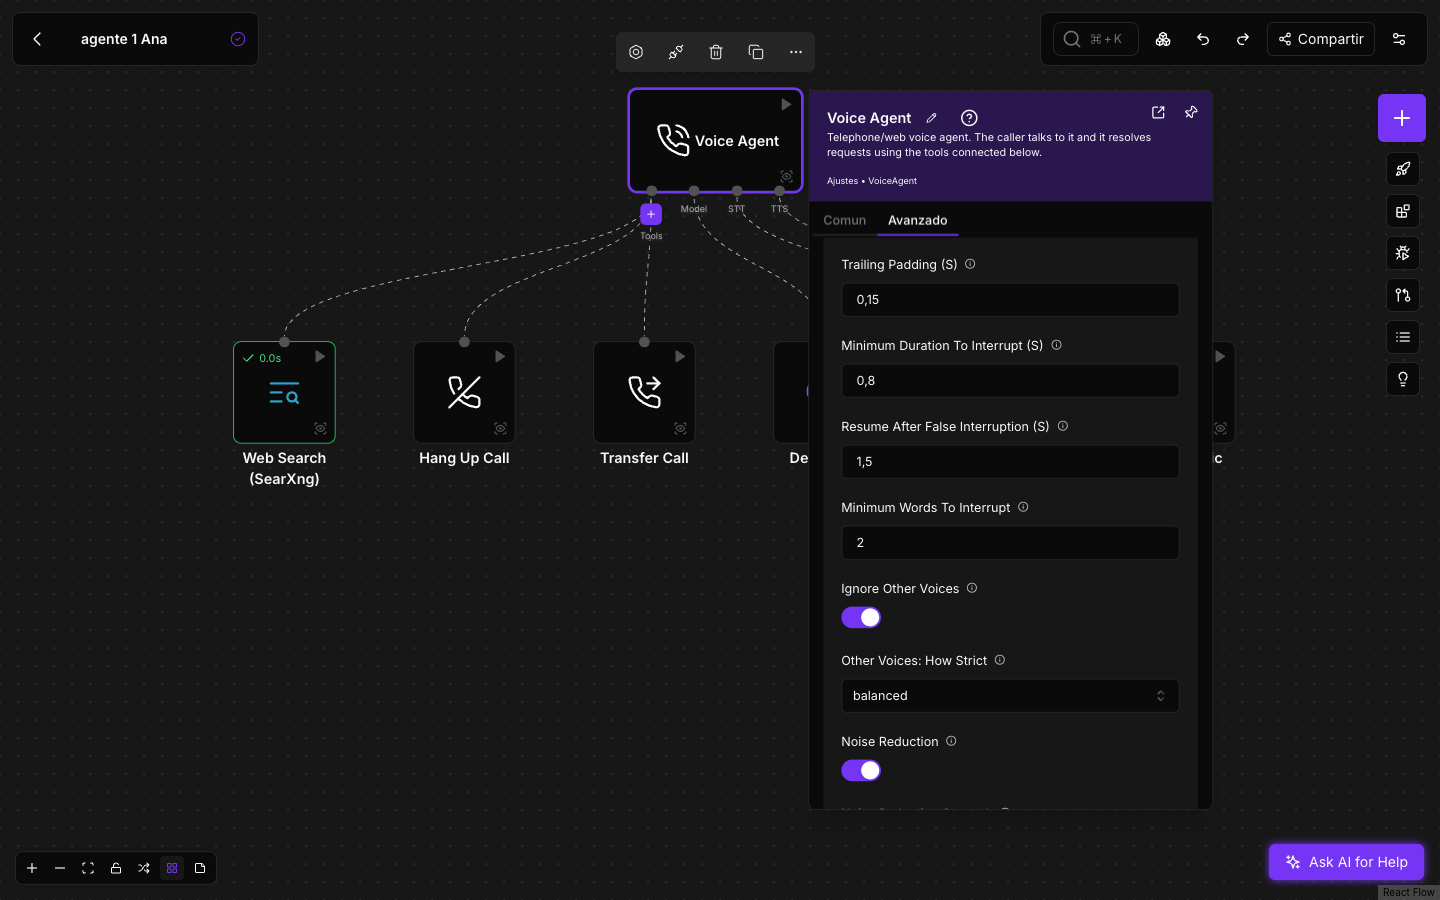
En la calle, en un coche, en una oficina o con la tele puesta, el agente puede oír cosas que no son del llamante. El componente Voice Agent tiene varias defensas en Avanzado → VAD and Audio. Los valores por defecto ya son los recomendados para teléfono y ruido.
| Ajuste | Por defecto | Qué hace |
|---|---|---|
| Noise Reduction | Activado | Limpia el ruido de fondo antes de decidir si el llamante habla. |
| Ignore Other Voices | Activado | Aprende la voz del llamante: es la que contesta al agente. Una voz que no es la suya (alguien detrás, una tele) no corta al agente y, en cuanto el llamante está reconocido, tampoco recibe respuesta. Funciona con cualquier STT y no añade espera. |
| Other Voices: How Strict | balanced | gentle ignora solo voces claramente distintas; balanced es el punto recomendado; strict ignora más voces de fondo, a cambio de que el llamante tenga que repetir alguna vez una palabra muy corta. |
| Minimum Duration To Interrupt (S) | 0,8 | Cuántos segundos debe hablar el llamante para cortar al agente. Un claxon o una palabra suelta no lo interrumpen. |
| Minimum Words To Interrupt | 2 | Palabras necesarias para cortar al agente, con los STT que transcriben mientras se habla, como Vosk, Deepgram o Azure. |
| Speech Sensitivity | 0,7 | Súbela un poco, por ejemplo a 0,75, si el ruido se toma por voz. |
El agente reconoce al llamante en los primeros segundos de conversación y, si al principio confundió su voz con otra (por ejemplo, una radio que sonaba antes), se corrige solo en cuanto el llamante contesta.
Si el llamante y otra voz hablan a la vez, sin pausa entre medias, el agente recibe la frase mezclada.
Si el agente responde a una tele o a alguien de fondo, prueba Other Voices: How Strict en strict. Si alguna vez ignora al propio llamante, vuelve a balanced o a gentle.
Limpieza automática del audio
Además de estos ajustes, NappAI limpia el audio de cada llamada sin que tengas que configurar nada:
- Desde el navegador (el widget de tu web y el playground), el ruido de fondo y el eco se eliminan en el propio dispositivo del llamante, antes de que la voz salga hacia el agente, y el volumen del micrófono se ajusta solo. En los dispositivos que lo permiten se aísla además la voz del resto de sonidos.
- Por teléfono, el ruido de la línea se reduce antes de transcribir siempre que eso mejora lo que el agente entiende. Se aplica solo a lo que se transcribe: el reconocimiento de la voz del llamante y la detección de cuándo habla siguen trabajando con el audio original, para no confundirlo con otra persona. No añade espera a la respuesta.
- Con gente hablando de fondo (un bar, una cafetería, una oficina abierta), un modelo de IA que funciona dentro de NappAI distingue la voz cercana del llamante del murmullo. Así el agente sabe cuándo ha terminado de hablar y contesta a tiempo, en lugar de esperar a que la sala se quede en silencio. Cuando el llamante se calla en un entorno tranquilo, el turno se cierra igual de rápido que sin el modelo. Lo controla Noise Reduction.
- Con los proveedores que la ofrecen, se activa además su propia reducción de ruido antes de que su modelo oiga al llamante.
Cómo el agente detecta cuándo habla el llamante y cuándo ha terminado, capa a capa, se explica en Cómo funciona un agente de voz.
Ambiente de la llamada
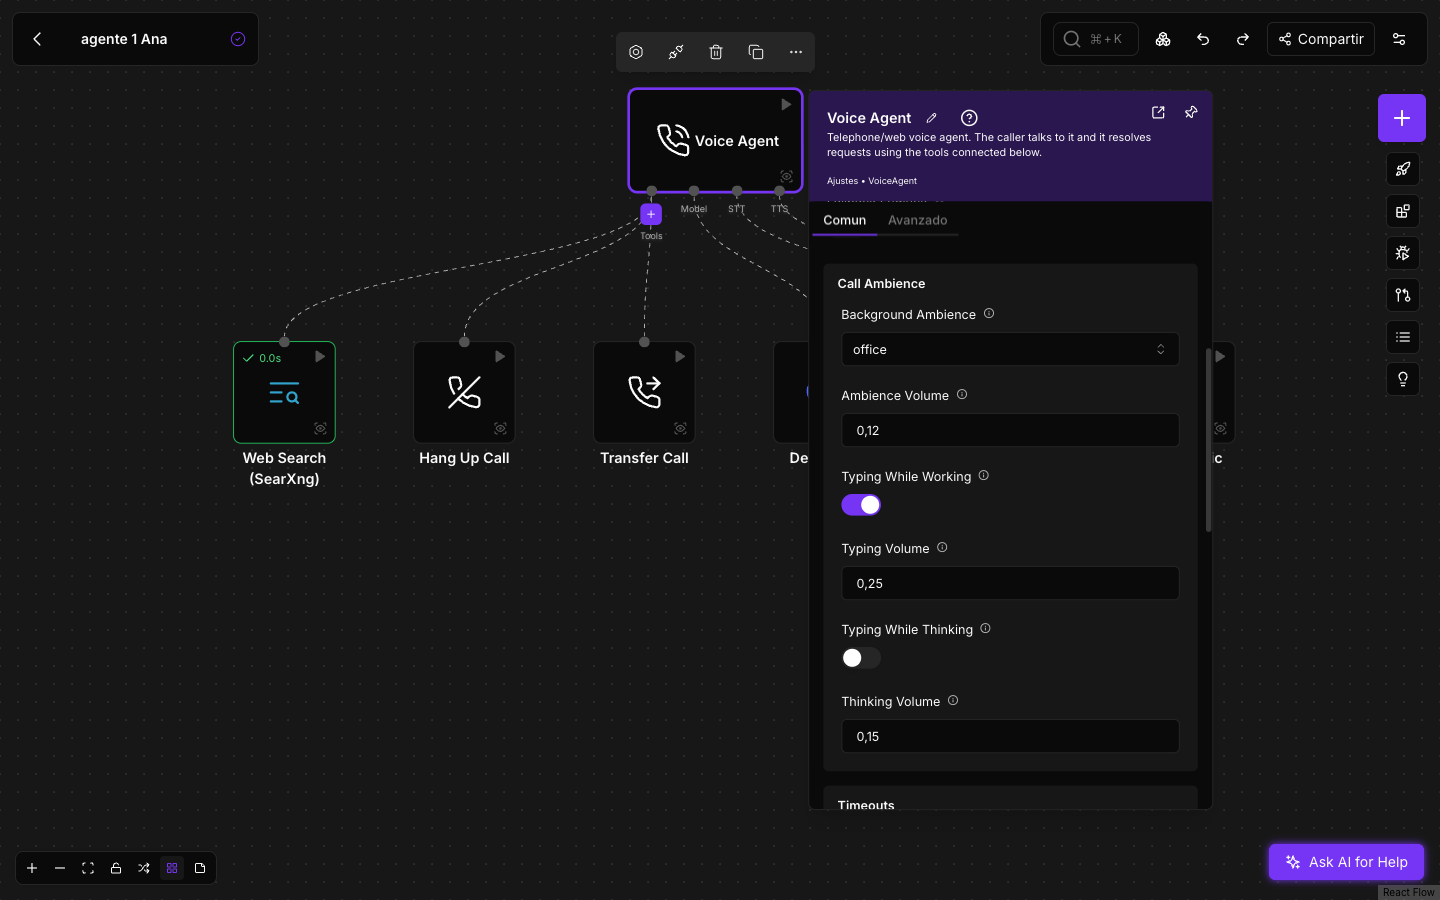
Un silencio total al otro lado suena a llamada cortada. Por eso, por defecto, el agente pone un ambiente de oficina muy suave durante toda la llamada y un teclado mientras una herramienta trabaja. Se ajusta en el grupo Call Ambience de la pestaña Comun.
- Background Ambience:
officepor defecto; tambiéncity,forest,crowded_room, o vacío para silencio. Ambience Volume: 0,12. - Typing While Working: activado por defecto, con Typing Volume 0,25. Suena solo mientras una herramienta trabaja.
- Typing While Thinking: desactivado por defecto. Un teclado suave mientras el agente prepara cada respuesta, con su propio Thinking Volume.
Para una línea en silencio, deja el ambiente vacío y desactiva el teclado.
Latencia
La latencia es la espera que nota el llamante: desde que termina de hablar hasta que oye al agente. Aparece bajo cada respuesta en el detalle de la llamada.
Tiene tres tramos:
- Fin del turno y transcripción. El agente espera un silencio breve para saber que el llamante ha terminado y transcribe lo que ha dicho.
- El modelo. Es el tramo que más pesa y el que más varía entre proveedores y modelos.
- La primera frase de voz. El TTS empieza por la primera frase sin esperar al resto de la respuesta.
Qué hacer, por orden de impacto:
- Elige un modelo rápido. En los modelos que razonan, deja el razonamiento bajo o apagado: una llamada necesita respuestas ágiles, no un informe.
- Prompt corto y claro. El modelo lo lee en cada turno. Evita prompts de varias páginas.
- Respuestas cortas. Pide en el prompt frases breves: la primera frase suena antes y el llamante puede interrumpir.
- Quality de Supertonic en
4 steps — Fastsi la primera frase tarda: sale antes, a cambio de un poco de naturalidad. - Pocket TTS si necesitas que empiece a hablar todavía antes. Solo habla español.
- Herramientas rápidas. Mientras una herramienta trabaja, el agente cubre la espera, pero el llamante nota una espera larga. Limita los resultados de las búsquedas y evita encadenar herramientas lentas.
- No acortes el fin de turno para ganar velocidad. Silence For End Of Turn (S) viene pensado para no cortar a la gente en entornos ruidosos. Por debajo, el agente contesta antes de que el llamante termine.